多行字符:识别多行文字
一个框圈住一整块文字,软件把它切成一行一行分别识别,每行可以单独设参考内容和比对松紧。适合地址块、多行规格参数、多行说明这种"内容几行、行数固定"的地方。
如果只有一行字,而且每件产品的内容都一样,用字符识别更省事;一行字但每件都不同,用可变区域。多行字符的特点是一个框管好几行,并且比对用的是整行相似度,不是逐字模板。
前置条件
- 检测方案里已经建好标签外框,模板图已经完成旋转拉伸。
- 文字在模板图上清晰可读,人眼能认出来。人都认不出的字,软件也认不出。
它包含哪些检测框
新建一个"多行字符"检测项后,树里它下面有两个检测框:
| 检测框 | 管什么 |
|---|---|
| "搜索参数" | 允许这块文字相对模板漂移多少。文字位置每件都稳,就把容忍值调小 |
| "多行字符参数" | 识别与比对的全部设置,是主要调参的地方 |
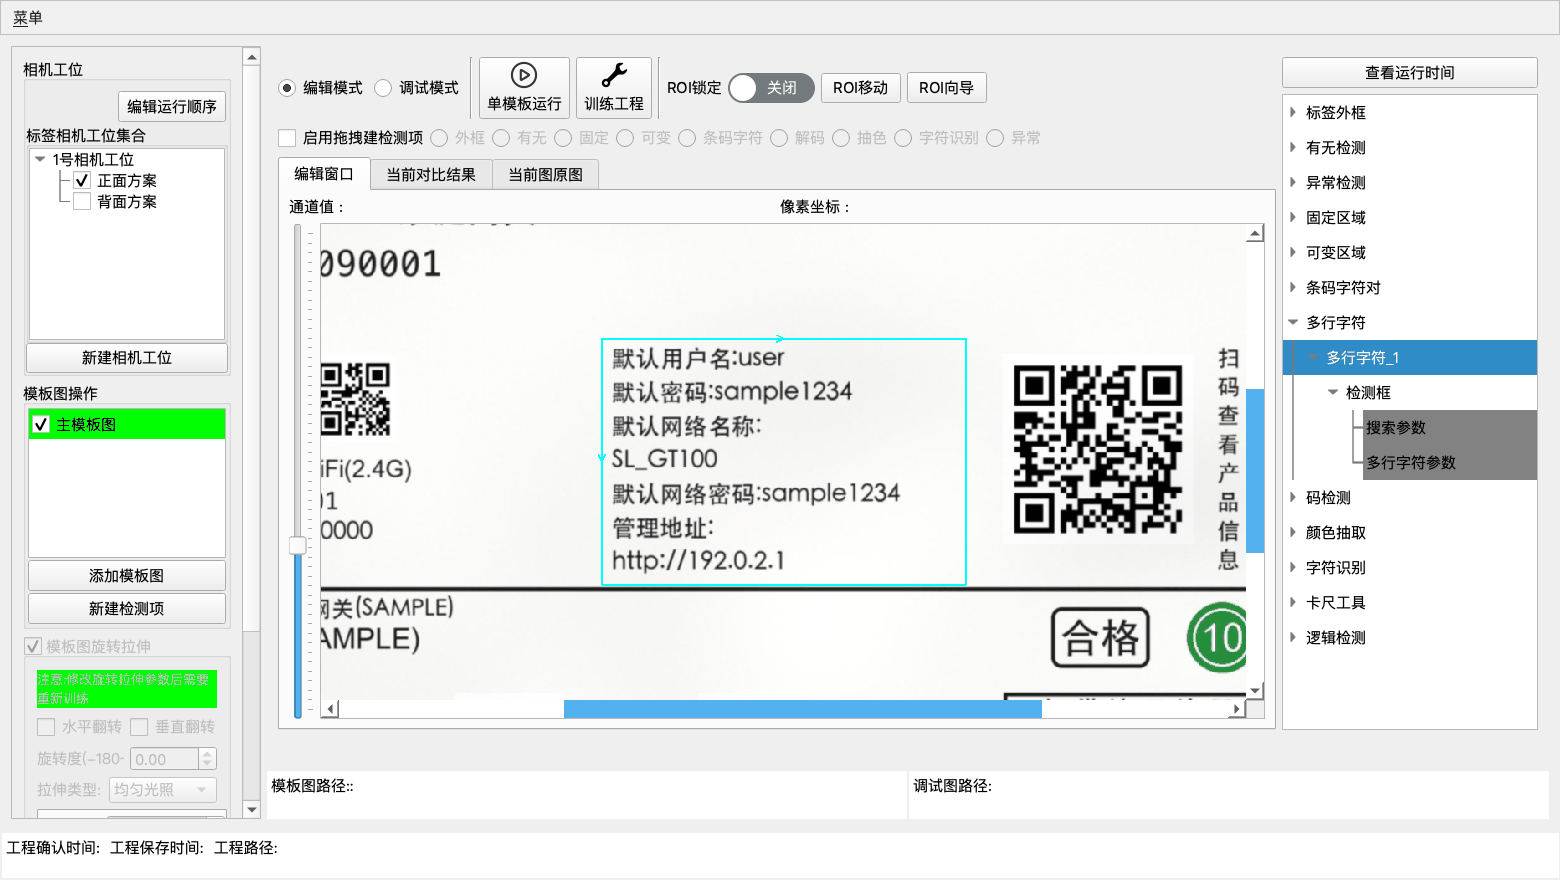
新建与画框
- 切到"编辑模式"。
- 点工具栏"新建检测项",类型选"多行字符",确定。
- 在模板图上把整块文字拖进一个框里。框要把所有要认的行全包住,上下左右各留一点空白,不要贴着字边切。
- 点工具栏"训练工程"。
- 在树里双击"多行字符参数",打开参数窗口,点窗口左上角的运行按钮跑一次,看识别结果。
框不要拖得过大
框里混进旁边的其它文字,会被当成额外的行,把行序冲乱。宁可框得紧凑,也不要顺手把半行别的内容圈进来。
参数说明
"多行字符参数"— 上方通用设置
| 参数 | 含义 | 调参建议 |
|---|---|---|
| "提取行数" | 这个框里要识别几行 | 按实际行数填。软件按从上到下的顺序取,取满就停,多余的行不识别 |
| "分数阈值" | 单行识别的置信度门槛,低于它这一行直接丢弃 | 默认 0.8。字印得浅或有底纹时适当降到 0.6~0.7;降太低会把噪点认成字 |
| "旋转补偿" | 把框内图像整体旋转 0 / 90 / 180 / 270 度再识别 | 文字在图上是竖的或倒的才用。识别引擎对正向字最准 |
| "当前识别结果设为参考" | 把这次认出来的每一行,一键填进各行的"参考字符"(按钮在逐行表格正上方) | 模板图认对了再点。认错了点它等于把错的存成标准答案 |
| "是否屏蔽其余检测项ROI" | 把别的检测项的框覆盖掉再识别 | 旁边的框压到这块文字上时打开。周围检测项多的时候不建议开,容易把要认的字也挡掉 |
| "预处理" | 勾上后先做一次二值化增强再识别 | 字浅、背景脏时试着打开 |
| "二值化阈值" | "预处理"打开后生效(不勾时置灰),0~255 | 从 125 起调。调到结果图里字是黑的、底是白的、笔画不断为宜 |
"多行字符参数"— 逐行表格
表格一行对应图上的一行文字。左边几列是结果,右边几列是这一行的判定规则。
| 列 | 含义 | 调参建议 |
|---|---|---|
| "识别结果" | 去掉空格 / 冒号等之后的识别内容 | 只读 |
| "分数" | 这一行的识别置信度 | 只读。长期低于 0.8 说明取像或光照要改 |
| "验证结果" | 勾上才拿这一行和"参考字符"比对;不勾只识别不判 | 只要读出来上传、不需要判对错的行,取消勾选 |
| "参考字符" | 这一行的标准答案 | 可直接在格子里输入,也可用"当前识别结果设为参考"批量填 |
| "相似度分数" | 本次结果与参考字符的相似度,0~1 | 只读 |
| "相似度阈值" | 相似度达到它才算 PASS | 默认 1.00,即必须一字不差。个别字容易认混又不影响品质时,可放到 0.9 左右 |
| "忽略符号" | 只保留字母和数字,其余符号全去掉再比 | 参考字符里带括号、斜杠、点号且这些符号常被认错时打开 |
| "忽略空格" | 比对前去掉空格 | 默认打开,建议保持 |
| "忽略冒号" | 比对前去掉中英文冒号 | 默认打开,建议保持 |
| "裁切" | 只取这一行的一段来比对 | 行里只有中间一截是固定内容时用 |
| "裁切起始" / "裁切结束" | 取第几个字符到第几个字符 | 从第 1 个字符开始数 |
| "最终结果" | 这一行经过忽略 / 裁切之后,真正参与比对的内容 | 只读。比对总不通过时先看这一列,常常是符号没去干净 |
点表格里的任意一行,下方"结果详细信息"会展开这一行的"识别结果:""分数:""参考字符:""相似度分数:""最终结果:",方便逐行核对。
"搜索参数"
| 参数 | 含义 | 调参建议 |
|---|---|---|
| "扩张参数" | 勾上才允许框按下面的容忍值向外扩 | 文字位置每件都稳,可以不勾 |
| "横向偏移容忍绝对值" | 允许左右漂多少像素 | 默认 10。按产品实际漂移量给,给大了会把旁边内容吃进来 |
| "纵向偏移容忍绝对值" | 允许上下漂多少像素 | 默认 5 |
| "横向锁定" / "纵向锁定" | 锁住这个方向不扩张 | 只在某一个方向会漂时,把另一个方向锁上 |
训练与调试
- 画完框、改完参数,先点"训练工程"。
- 双击"多行字符参数",点运行按钮跑一次。
- 窗口左侧的结果图下拉框里可以逐张看中间产物:"检测掩模""检测区域图""旋转图""第1行""第2行"……"结果图"。哪一行切得不对,看"第N行"那张图最直接。
- 模板图上认对了以后,点"当前识别结果设为参考",再逐行调"相似度阈值"和三个"忽略"开关。
- 用"打开调试图"或"打开调试文件夹"把现场的实拍图过一遍,确认每张都稳定。
- 全部确认后回主界面点"保存工程"。
常见误判与处理
| 现象 | 原因 | 处理 |
|---|---|---|
| 识别出来的行数少于设定行数,整项判 NG | 有的行"分数"低于"分数阈值",被丢掉了 | 先看结果图哪行没框出来;降低"分数阈值",或改善这块的照明与对焦 |
| 行序错乱,第 1 行的内容跑到第 2 行 | 框里混进了旁边其它内容,被当成一行 | 把框收紧,只包住要认的文字 |
| 识别结果对,但比对不通过 | "最终结果"里还留着符号 / 空格,和"参考字符"对不上 | 打开"忽略符号""忽略空格""忽略冒号";或直接用"当前识别结果设为参考"重填参考字符 |
| 某个字长期被认成形近字(0 和 O、1 和 I) | 印刷字体本身难分 | 把这一行的"相似度阈值"从 1.00 放到 0.9 左右,或改用"裁切"只比对稳定的那一段 |
| 文字是竖排或倒的,完全认不出 | 引擎只认正向文字 | 用"旋转补偿"转到正向;仍不行就调整相机安装方向 |
| 打开"是否屏蔽其余检测项ROI"后反而认不到 | 相邻检测项的框压住了要认的文字,被一起屏蔽了 | 关掉这个开关,或把相邻检测项的框缩小 |
| 首次运行这一项特别慢 | 识别引擎第一次使用时要加载 | 属正常现象,之后恢复。正式运行前先在调试端跑一次 |