字模 OCV:逐字查印刷缺陷
字模 OCV 的比对算法移植自 HALCON 的 OCV 流程,不需要装 HALCON。
字模 OCV 是字符类检测项"缺陷参数"的算法(也是唯一的算法):先把一行字切成一个个字符,再把每个字和"字体库"里存的该字样本(字模)比,比不像的字判 NG。
它挂在三种检测项下面:字符识别、可变区域的字符框、条码字符对的明文框。树上的节点文字是"缺陷参数(字模OCV)"。
老工程里的老字符缺陷配置
老的字符缺陷算法(TightOcr)已经下线。老工程里用它配过的字体库和参数,升级后打开工程时会被丢弃,并弹框列出是哪几个检测项;请在字模 OCV 里重新选字体库、建样本,关掉提示框再保存工程,下次打开就不再提示。老工程里没启用过缺陷参数(只查内容对不对)的检测项也会列在提示里,不用重配。
前置条件
- "检测参数"(认字)已经调好,能稳定认对、比对通过。缺陷比对拿认字结果当"这里应该是哪几个字"。
- 一个框只框一行字。
- 字高不小于 30 像素。字太小切字会不准,误报会多;不够就把相机拉近或换镜头。
字体库
字体库存在本机的 C:\Users\<用户名>\.labeldetect\ocv_fonts\ 下,工程文件里只记字体库的名字。同一台电脑上不同工程、换料后的新工程可以直接选用同一个字体库。
- 换电脑时,在老电脑上点"导出"存成
.ocvfont文件,到新电脑上点"导入"。导入时同名库已存在会问是否覆盖;选"否"就再输入一个新名字导入。工程拷到新电脑先打开对话框不会丢字体库名(会提示本机没有这个库),导入同名库即恢复。 - 老版本外挂 OCV 的字体库(
.labeldetect\ocv\下的.ocv文件)会在打开字体库列表时自动转成新格式导入,老文件不动。 - 字体库名只能用字母、数字、下划线、减号和汉字。
- 每个字符最多存 10 个样本。
能比对的字符:大小写字母、数字和 @#$&()+-/:;<>=?![]*。其它字符(如空格、中文)不参与比对。
建库流程
- 在树里选中检测项下的"缺陷参数(字模OCV)",右键"启用此检测项",双击打开,在"字体库"一栏点"New",输入字体库名,"确定"。字体库还是空的时,字体库一栏下面会提示下一步怎么做。
- 点本窗口工具栏的运行按钮检测一次(或关掉窗口,在树里选中检测项右键"运行此检测项")。库里还没有样本的字会报"缺模板",左边字符列表里是 ×0;点"当前字符全部加为模板",把这一行切出来的字一次全部存成样本。运行本身不会往字体库里写任何东西。
- 再检测一次,应为 PASS。左边字符列表每格显示"字符 ×样本数",这一行出现的字都应该是 ×1 以上;点某个字,右边会显示它的样本图。
- 首件本身有缺陷、样本学错了:在字符列表选中那个字,用画廊左右翻到错的那张,点"删除模板",再用"手动添加模板"补一张,或换一件好品跑一次后点"当前字符全部加为模板";好的字被误判 NG,点"NG字符全部加为模板"把这次判 NG 的字都补成样本。
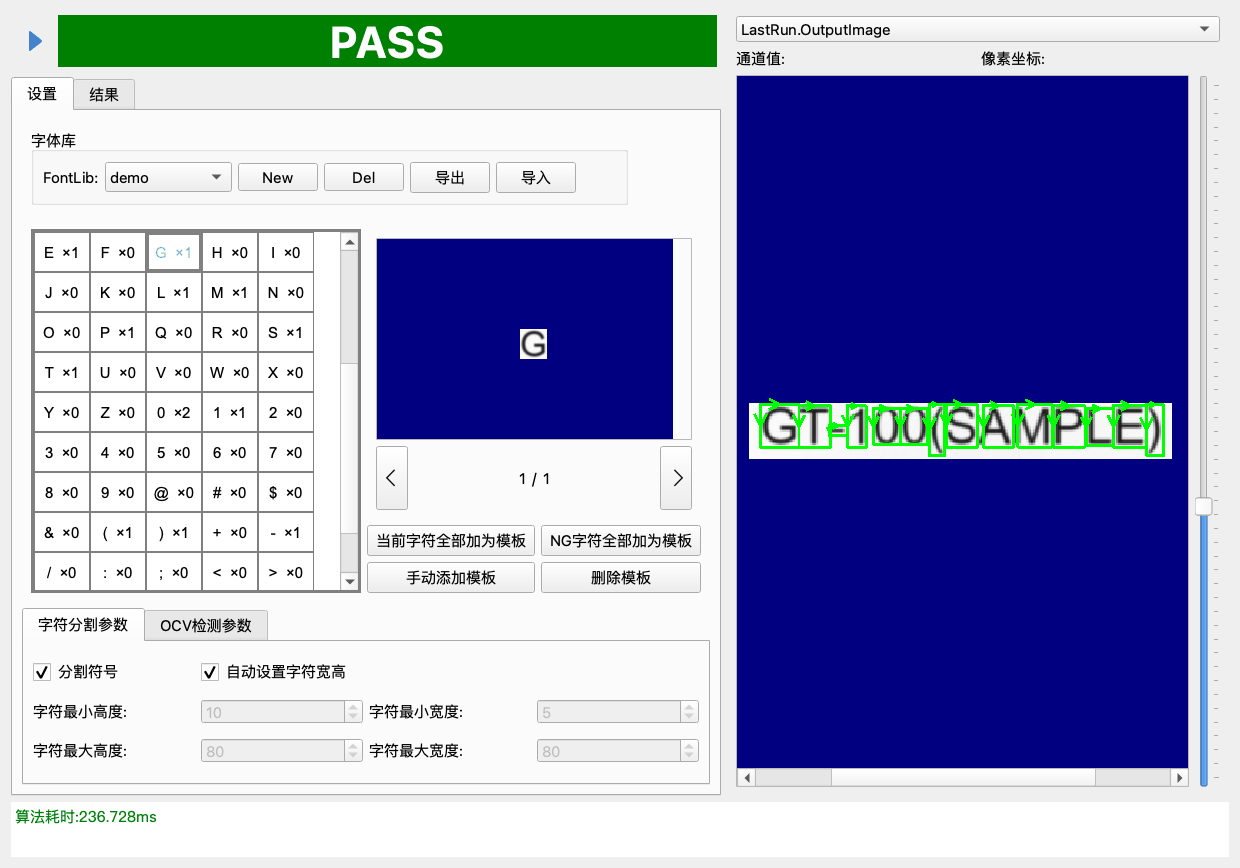
模板按钮(画廊下方,两行两列):
| 按钮 | 作用 |
|---|---|
| 当前字符全部加为模板 | 把本次检测切出来的每个字都存成样本,不用先选字。已经在库里的同一张图会跳过;某个字已满 10 个样本时跳过这个字,完成后提示加了几个、跳过几个 |
| NG字符全部加为模板 | 把本次所有判 NG 的字(含"缺模板"的字)按字分别存成样本,不用先选字 |
| 手动添加模板 | 先在字符列表选中要补的字,点按钮,在弹出的"添加模板"窗口里把框拖到这个字上,点"添加" |
| 删除模板 | 删掉画廊当前显示的那张样本 |
两个"全部加为模板"都用本窗口上一次检测的结果;结果来自别的字体库、切分失败时会提示先重新检测或调整分割参数。
字体库只在你点按钮时改变
任何运行(调试端、运行端、命令行)都不会自动往字体库里加样本。可变内容(日期、流水号)要在上线前把可能出现的字都加全——每种字至少让它出现在一次检测里,点"当前字符全部加为模板";没加过的字在生产里会报"缺模板: X"。字符列表里的样本数就是覆盖表,上线前逐个检查。
本窗口的检测按钮用的是检测项上一次运行留下的图和认字结果。检测项还没运行过时会提示"请先运行检测项"。
参数
字体库一栏:
| 项 | 填写 | 说明 |
|---|---|---|
| FontLib | 下拉选字体库 | 空着每件都报"请先新建或选择字体" |
| New / Del | 新建 / 删除字体库 | 删除会删掉本机这个字体库的全部样本,其它用它的工程也会受影响;从老外挂自动导入的库删掉后不会再自动导回,要用再手动导入 |
| 导出 / 导入 | .ocvfont 文件 |
换电脑、备份用 |
字符分割参数页:
| 项 | 默认 | 说明 |
|---|---|---|
| 分割符号 | 勾 | 不勾时符号照样参与切字(它们是版面的一部分),只是不比对 |
| 自动设置字符宽高 | 勾 | 按这一行的字自动估字宽字高;勾着时下面四个数置灰不用 |
| 字符最小高度 / 字符最大高度 | 10 / 80 | 像素。自动不准时取消"自动设置字符宽高"再手填 |
| 字符最小宽度 / 字符最大宽度 | 5 / 80 | 像素 |
OCV检测参数页:
| 项 | 默认 | 说明 |
|---|---|---|
| 比对方式 | 逐像素比对(推荐) | 逐像素比对:先用样本在这一行里找准字的位置,再逐点和样本比,能抓缺角、污渍、压在笔画上的灰斑。投影比对(HALCON 同款):老外挂的算法,只看每行、每列的平均灰度,对压在笔画上的灰斑看不见;老用户习惯老行为时选它。注意:逐像素对 2 px 以下的细笔画缺墨看不见(笔画两侧各 1 px 是允许的边缘误差),笔画 ≥ 3 px 的整笔缺失、断笔能报;喷码 / 热敏 / 小字号请提高分辨率让字高 ≥ 30 px、笔画 ≥ 3 px,或改选投影比对 |
| 允许灰度差 | 25 | 1~255。实拍和样本灰度差多少以内算一样;误报多就调大。两种比对方式都用(老外挂默认 20) |
| 分数阈值 | 0.8 | 0.05~0.95。只在投影比对下有效:每个字的相似度低于它判 NG,越大越严;逐像素比对时置灰不用 |
| 适应光照变化 | 勾 | 整体明暗变化不算缺陷;两种比对方式都用 |
| 适应缩放 | 勾 | 只在投影比对下有效:字的大小略有变化不算缺陷;逐像素比对时置灰不用 |
| 图上只标NG框 | 勾 | 结果图上只画判 NG 的字的红框;结果表不受影响,总是列出全部字 |
看结果
"结果"页表格从左到右列出这一行的每个字和"位置""分数",判 NG 的行是红字。右侧图像选"LastRun.OutputImage",每个字画一个框:红框是 NG,绿框是通过(勾了"图上只标NG框"时结果图只画红框)。表上方的红字是 NG 原因:
| 结果 | 含义 | 处理 |
|---|---|---|
NG: X |
这些字和样本比不像 | 看图确认真有缺陷;好的字被误判就点"NG字符全部加为模板",或适当调大"允许灰度差"(投影比对还可调小"分数阈值");白纸过曝(灰度顶到 255)也会让好字误报,先把曝光降到纸色不饱和 |
缺模板: X |
字体库里没有这些字的样本 | 点"当前字符全部加为模板",或"手动添加模板" |
分割字符数量与OCR结果字符数量不相等,请检查分割参数和分割结果 |
切出来的字数和认出来的字数对不上,图上会把切出的候选框全画成红色 | 看候选框:字粘在一起或断开,就取消"自动设置字符宽高"手填字宽字高;多切出了符号,检查"分割符号"是否该勾 |
请先新建或选择字体 / 字体库 X 不存在 |
没选字体库,或本机没有这个字体库(换了电脑) | 选一个字体库,或从老电脑导出再导入(导入同名库即恢复,工程里的字体库名不会丢) |
参考串为空 |
认字结果里没有可比对的字符 | 先把"检测参数"调到能认出字 |
开始运行时,如果启用的检测项用的字体库在本机不存在,日志区会提示一条"字模OCV 字体库缺失"。
注意事项
- 样本只在点"…加为模板"时写入。首件本身有缺陷就别点"当前字符全部加为模板",先看图,或加完后在字符列表里把错的那张删掉。
- 字体库是本机全局的:在一个工程里删样本、删库,会影响本机所有用这个字体库的工程。
- 同名字体库在不同电脑上内容可能不同,换电脑请用导出 / 导入搬,不要各自重新建库。工程拷到新电脑先打开对话框不会丢字体库名,导入同名库即恢复。