可变区域:检查会变化的字符内容
可变区域用来读每件都不一样的一行字:流水号、生产日期、批次号、密码。它不能拿模板图当标准答案逐像素比,只能把字认出来,再按你定的规则判合不合格。
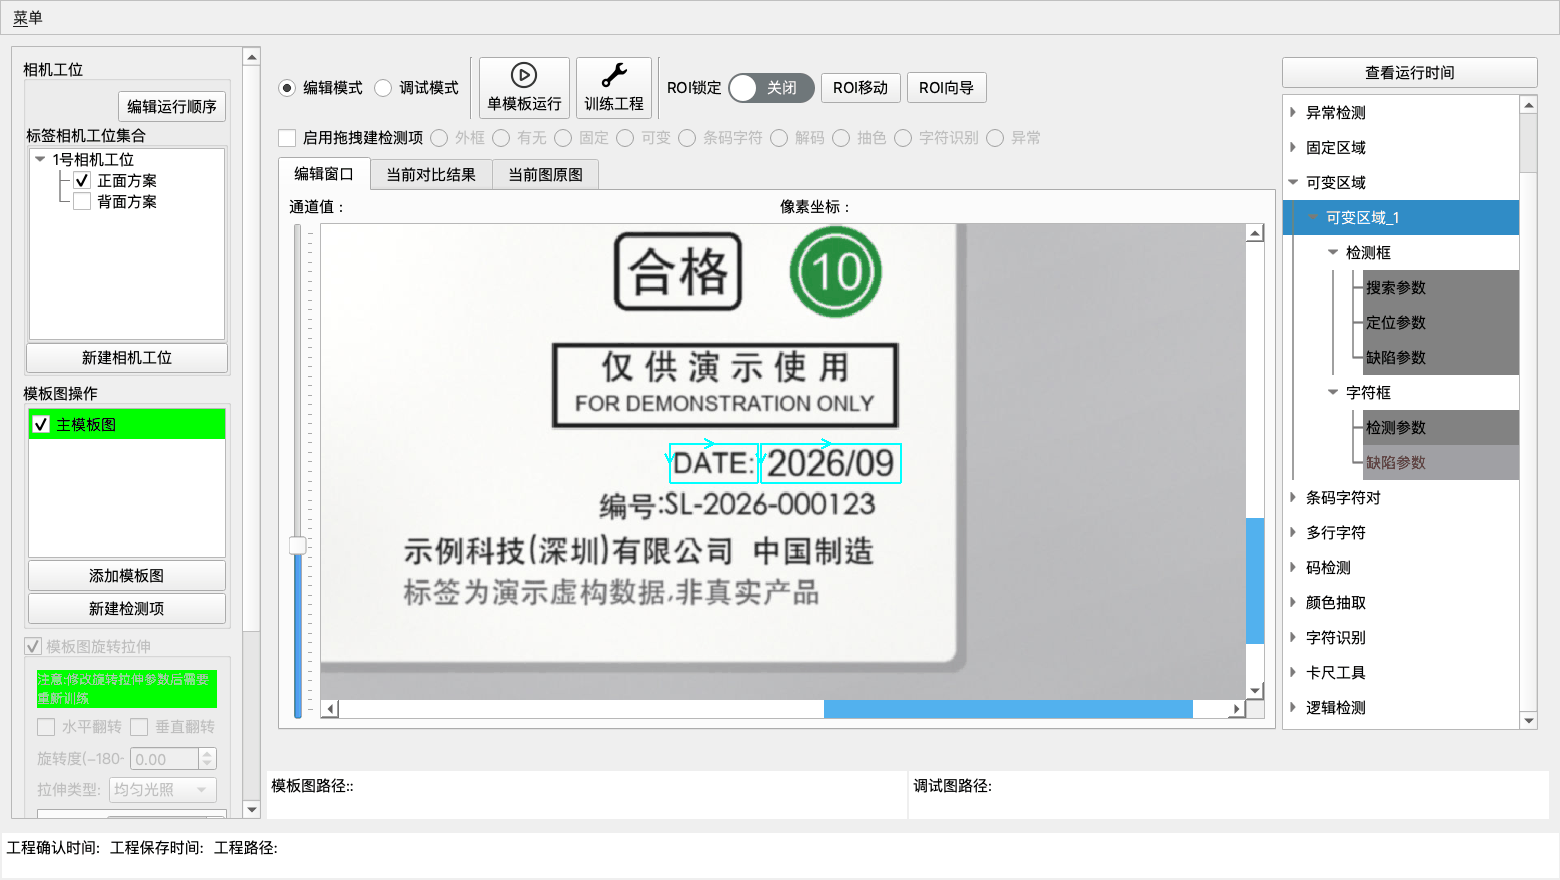
它是一对框:一个检测框框住旁边内容固定的部分(比如"生产日期:"这几个字)当参照物,一个字符框框住会变的内容。参照物找准了,字符框才跟着落到正确位置。
前置条件
- 检测方案里已经有标签外框,并且训练过。
- 会变的这行字旁边有一块内容固定的东西可以当参照。实在没有,就把检测框放在附近任何固定的图案或边框上。
它包含哪些检测框
检测框(参照物,用法和固定区域完全一样):
| 检测框 | 干什么 | 默认 |
|---|---|---|
| 搜索参数 | 允许参照物漂移多大范围 | 开 |
| 定位参数 | 在这个范围里按形状把参照物精确找出来 | 开 |
| 缺陷参数 | 检查参照物本身印得好不好 | 开 |
字符框(会变的内容):
| 检测框 | 干什么 | 默认 |
|---|---|---|
| 检测参数 | 认字,并按规则比对 | 开 |
| 缺陷参数 | 逐个字符查笔画有没有缺、糊、多墨(字模 OCV) | 关,要用得先右键"启用此检测项",再按字模 OCV建字体库 |
还可以在树里选中这个检测项右键,用"添加细节检测框""添加屏蔽内容检测框"再加两种框。
新建与画框
- 点工具栏"新建检测项",类型选"可变区域",确定。
- 模板图左上角出现两个绿框。点其中一个,右侧树里对应的那条会高亮,用这个办法分清哪个是检测框、哪个是字符框。
- 把检测框拖到那块固定内容上,贴紧,别切字。
- 把字符框拖到会变的那行字上:
- 上下要留一点余量,别贴着字顶和字底切;左右要够长,能容下最长的那种内容。
- 框里只放这一行。上下行的字被框进来,认出来的结果就会串行。
- 框里尽量不要有边框线、下划线、条码这类东西。
- Ctrl+T"训练工程",再"单模板运行"。
参数说明
检测框的三个检测框参数和固定区域一模一样,见固定区域。下面只讲字符框。
字符框 —— 检测参数
这一页分三块,顶部还有"设置""混淆字符""替换字符"三个标签页。
预处理参数:
| 参数 | 含义 | 调参建议 |
|---|---|---|
| 白底黑字 | 告诉软件字是深的还是浅的:勾上 = 白底黑字,不勾 = 黑底白字 | 按实际勾。弄反了基本认不出字 |
| 英文模型 | 用哪套识别模型:勾上 = 英文模型,只认数字、英文字母和常见符号;不勾 = 中英文模型,还认汉字 | 内容里没有汉字就一定勾上"英文模型"——它不会把字母认成汉字,更稳也更快。有汉字才取消勾选(用中英文模型) |
| 旋转角度 | 把这块图先转 0、90、180 或 270 度再认 | 软件只认横排正向的字。竖排或倒排的字必须在这里转正 |
| X方向缩放 | 认之前把图横向拉伸或压缩的倍数 | 默认 1。字被压扁(常见于喷码)时调到 1.5~2 会明显变准 |
| Y方向缩放 | 纵向同上 | 默认 1。字太矮太小时往上调 |
| 最小字符高度 / 最小限定框高度 | 勾上"最小字符高度"后,比"最小限定框高度"矮的笔画会先被抹掉再认;不勾时数值框置灰 | 用来去掉框里混进来的细线、下划线、上下行漏进来的半截字。"最小限定框高度"填的数值参考:把鼠标在图上量一下正常字符的高度,取它的一半左右 |
比对参数:
| 参数 | 含义 | 调参建议 |
|---|---|---|
| 中文符号转英文 | 把全角的括号、逗号、冒号统一换成半角再用 | 默认开着,一般别关 |
| 忽略符号(仅比对用) | 比对时把所有非字母数字的字符都丢掉,只比字母和数字。不影响输出的结果 | 内容里的符号识别不稳、但你只关心字母数字对不对时开 |
| 过滤符号(结果输出) | 直接把非字母数字从输出结果里删掉 | 要把结果发给 MES 或写进记录,而符号是噪声时才开。开了以后别的地方拿到的也是删过的 |
| 置信度阈值 | 识别结果的可信程度要达到多少,0~1 | 默认 0.8。这是判"印糊了"的主力:印花了置信度就掉下来。误报多就降到 0.6~0.7,漏检糊字就升到 0.85 |
| 字符串长度限制 | 结果必须正好这么多个字符,否则 NG。填 -1 表示不检查 | 内容位数固定(比如流水号永远 10 位)时一定要填,能一下子拦住少印、多印、被遮挡 |
| 与参考字符串比对 | 是否拿结果和"参考字符串"对一遍;不勾时"比对方式""参考字符串"置灰 | 可变区域的内容每件都不一样,通常关掉,只靠置信度和长度判定。只有内容其实有固定前缀时才开 |
| 比对方式 | 三选一:参考字符串在结果字符串中 / 结果字符串在参考字符串中 / 结果字符串等于参考字符串 | 只想卡固定前缀就用"参考字符串在结果字符串中" |
| 参考字符串 | 拿来比对的那串字 | 点它下面的"设为当前识别结果"可以把这次认出来的直接填进去 |
识别结果:显示"结果字符串"和"结果置信度",是只读的。调参时全靠它。
混淆字符页:每一行是一组"互相认错也当对"的字符,比如 1Il、oO0。左列是组名,不能改;右列填这一组里等价的字符。只在比对时起作用,不改输出结果。用"+"加一组,选中行用删除图标删一组。
替换字符页:两列,左列"原字符",右列"替换为"。凡是识别结果里出现左列的内容,一律换成右列的。用来兜底修一些固定认错,比如老把某个符号认成别的。它改的是输出结果本身。
判定顺序是固定的,照这个顺序排查最快:认不出字 → NG;长度不等于"字符串长度限制" → NG;置信度低于"置信度阈值" → NG;开了比对而比对不过 → NG。
字符框 —— 缺陷参数
这一页查的是笔画本身有没有毛病——缺一角、糊成一团、多一个墨点。算法是字模 OCV:把每个字和字体库里存的样本比。启用、建字体库、调参和看结果全部见字模 OCV。
这一步只有客户明确要求查印刷质量时才做。只查内容对不对的话,"检测参数"就够了。
训练与调试
- 动过框的位置就必须 Ctrl+T"训练工程"。只改识别参数不用训练。
- 右键"运行此检测项"单跑,看"检测参数"里的"结果字符串"和"结果置信度"。
- 结果图片下拉框里有三张关键图:
- 输入图片:字符框实际抠出来的那块。抠歪、切字、混进别的行,都在这里看得出来,要回去调框或调检测框的定位。
- 旋转矫正图:转正并缩放之后送去识别的图。这才是模型真正看到的东西。
- 预处理图:勾了"最小字符高度"才有,能看到细线被抹掉后的样子。
- 换十几张不同内容的实拍图跑一遍,记下最低的那个置信度,把"置信度阈值"设在它下面一点点。
常见误判与处理
| 现象 | 原因 | 调哪里 |
|---|---|---|
| 完全认不出字 | 底色弄反,或方向不对 | 勾上或取消"白底黑字"(不勾 = 黑底白字);"旋转角度"转正 |
| 少认几个字或多认几个 | 字符框切到字了,或框里混进别的行 | 重新画字符框,上下左右各留一点余量,只框一行 |
| 数字被认成汉字 | 没勾"英文模型"(用的是中英文模型) | 内容里没汉字就勾上"英文模型" |
| 认出一串奇怪的短横线、下划线 | 框里有边框线或下划线 | 勾"最小字符高度","最小限定框高度"填正常字高的一半左右 |
| 喷码的扁字认不准 | 字被压扁 | 把"X方向缩放"调到 1.5~2 |
| 字很小认不准 | 分辨率不够 | 先想办法把"Y方向缩放"调大;根上的办法是换镜头或把相机拉近 |
| 正常品时不时 NG,结果串看着是对的 | 置信度卡太紧 | 把"置信度阈值"往下调,同时开"字符串长度限制"补上强度 |
| 内容位数少印了一位却判 PASS | 没开长度检查 | "字符串长度限制"填上正确位数 |
| 参照物定位失败,整件 NG | 检测框那侧的搜索范围或分数阈值不对 | 见固定区域的定位参数 |
| 缺陷参数一开就全 NG | 字体库里还没有样本,或认字结果和图上的字对不上 | 见字模 OCV:先把"检测参数"调到稳定认对,再"当前字符全部加为模板" |